|
|
老师同学们大家好,由于学术性论文版面限制和数据代码的非公开性使其读者并不能从论文中进行有效性学习,为此我们对具有非常经典且代表性的论文进行原文复现,使用通俗易懂的语言进行解释,我们一共做了八大类,包括数据来源口径、复现说明(复现常见问题给大家说明)、原始数据、数据处理过程、数据处理代码(包括数据处理、数据合并及回归运行代码)、最终结果数据(全部数据一张电子表格)、回归表格输出、word文档回归分析(手把手教大家写写实证论文),使大家能够更好的学习,节省大家宝贵的时间。
我们的初心一直是做真正能够使用并且可以公开的科研资料,公布数据处理过程及数据来源口径,把论文写作过程中所有黑箱都给大家打开看一看,无任何人为故意修饰部分,让科研写作更加合理可靠真实能公开!
复刻的文献都是顶刊经典文献(非关系稿,并且值得反复研究),向最优秀的期刊学习是提升自己科研能力的最有效措施,做个毕业论文、发个北大核心、C刊还是可实行的,比自己单独研究学习效率会提升很多!无论是初学者还是大学老师,都可以从中学习!
一、复刻文章
谷城, 吕康银, 秦利宾, 张佩雯. 算力供给的技术创新效应研究——来自国家超算中心设立的证据[J]. 数量经济技术经济研究, 2026(8): 82-100.
二、复刻内容介绍
数据年份为2025-2007年,一共是八部分,复刻前是两部分,复现说明和数据口径及来源,其余正文是六部分
1、复现说明=怎么跑+怎么看
· 全文复刻在做什么、结论怎么读
· 详细复现步骤与每一步的预期产出
· 每张表怎么看
· Python 版与 Stata 版逐步操作说明
· 复刻过程中常见问题解答
2、数据口径及来源=每个变量怎么定义、从哪来
· 样本口径来源与样本筛选
· 核心解释变量:算力供给 NSCC、处理组标识 Treat(12 个超算中心名单)
· 被解释变量:企业创新水平 8 个口径(INN 系列)
· 控制变量 12 个(企业层面 7 个 + 城市层面 5 个)
· 机制变量、拓展变量、分组变量
3、原始数据=全部源数据(16 项,均为可以从正规途径找到的真实数据,可整体打包带走)
· 专利明细
· 上市公司-国家超算中心DID(2000-2025年)
· 地级市-国家超级计算中心DID(2000-2025年)
· 国家超算中心名单
· 上市公司基本信息、CSMAR财务治理
· 城市统计年鉴(城市面板数据 + 地级市经纬度坐标)
· 员工构成(2011—2025 年)
· 文本语料(年报全文、管理层讨论与分析 MD&A)
· 主营业务构成
· 地级市IDC数据
· 省级年鉴
· 市场化指数
· 供应链
· 数字化转型
· 政策试点名单
· 城市列表
4、处理过程=中间过程数据(每一步都能查)
· mid1_核心变量(65,373 个企业—年份观测)
· mid2_控制变量(79,892)
· mid2b_机制与拓展变量(43,379)、mid2b_城市变量
· mid2c_分组与省级变量(79,892)
· mid2d_政策试点变量(5,643)
· mid2e_文本指标、mid2e_data 数据要素利用水平
· mid3_面板数据(5,403 家企业、55,825 个观测)最终回归面板
5、处理代码=Python+Stata 双版本,每个版本都能跑通可以复现!
(建议零基础或者代码理解能力不强的同学用 Stata,这个学起来会更简单,
而有一定基础建议用 Python,运行速度会更快,并且论文提到的文本分析必须用python)
00 一键运行总控、01 核心变量构造、02 控制变量、
02b 机制与拓展变量、02c 分组与省级变量、02d 政策试点变量、02e 文本指标、
02e2 数据要素利用水平、03 面板合并筛选缩尾、04 基准回归、05 全量扩展、
06 每表Word、07 最终数据Excel、08 论文文档、09 补充检验、10 Stata结果整理
6、最终数据=可直接回归的成品,最终结果数据
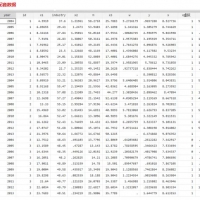
复刻回归数据.xlsx,全部数据一张电子表格
- 「回归变量」:55,825 个企业—年份观测、56 列,中文表头,可直接进回归
- 「变量说明」:变量名与口径定义
7、回归表格输出=论文所有回归表
· 表1 基准回归
· 表2 降低创新不确定性机制
· 表3 提升人才密度机制
· 表4 推动知识边界跨越机制
· 附表2 超算中心设立的政策效应
· 附表4 Altonji 遗漏变量检测、附表5 Oster 遗漏变量检测
· 附表8 细化创新类型
· 附表9 Bacon 分解
· 附表10 异质性处理效应检验
· 附表11 排除同期政策干扰
· 附表12 辐射范围与更换对照组
· 附表13 PSM 熵平衡与替换被解释变量
· 附表14 时变遗漏变量与剔除特殊样本
· 附表15 其他稳健性检验
· 附表16 知识边界跨越补充
· 附表17 TOE 异质性
· 附表18 拓展研究
· 附图5~附图11 事前趋势检验、相对偏离程度限制、平滑限制、空间安慰剂检验、
混合安慰剂检验、标准安慰剂检验、常规安慰剂检验
· 描述性统计(含相关系数矩阵)
· 每份 Word 含排好版的回归表格、表注与一段结果解读,中文字体宋体、
8、word文档回归分析=成稿,可以拿来直接使用!
· 论文解析.docx 研究问题→研究设计→逐表解读,零基础可以阅读
· 实证部分.docx 手把手教大家写一篇实证论文,可直接并入论文使用
内容丰富,绝对超值,原文数据为2007-2023年,我们将数据已更新2025-2007年,2025年为最新数据,并且附成文实证论文,数据代码无需更改直接使用,会极大提升大家科研效率!
需要说明的是由于《数量经济技术经济研究》公布部分数据和代码,但只是公布最终结果和回归代码,数据怎么来的,怎么合并处理的以及表格怎么输出的,文献及实证怎么分析的都是没有的
因此我们没有用到作者公布的那部分数据和代码,因此通过作者公布的最终结果和回归代码我们是复刻不出来(因为缺一大部分前期操作,也有可能是我们能力水平不够高),所以指标和变量都是通过权威途径一个个找取,每一步都能复现和做重复实验。数据在复刻过程中可能会出现显著性水平和作者不一样,因为数据来源和年份的延长等变了,属于正常现象!有需要可以下载系统学习,购买论文复刻的可速成学习!
此资料可以开票,购买页面申请即可,但凡让我们选中的论文极具研究价值!
|
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有帐号? 建议用  立即注册
x

|


 窥视卡
 雷达卡
 发表于
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜