|
|
1、资料名称:2025-2000年地级市国家大数据综合试验区DID数据、城市国家大数据综合试验区、Treat、试验区名称、批复年月、政策年份、相对时间、DID、所属省份、所属地域、胡焕庸线
2、测算方式:
参考《经济研究》林伯强老师的做法,以地级市为观测单位构造双重差分(DID)变量。核心操作步骤:
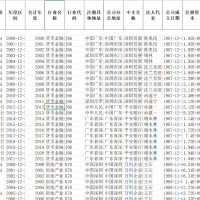
① 依据国务院《促进大数据发展行动纲要》及国家发展改革委、工业和信息化部、中央网信办批复文件,逐条整理出国家级大数据综合试验区名单及其覆盖区域、批复年月,并整理各试验区覆盖的地级及以上城市,逐条附来源网址;
② 以 297 个地级市的省份、6 位行政区划代码、所属地域与胡焕庸线为基础,按年份展开为「城市 × 年份」平衡面板(297 × 26 = 7,722 个观测);
③ 把地级市与试验区名单匹配:省(自治区、直辖市)口径的试验区按所属省份匹配,该省(自治区、直辖市)全部地级及以上城市均为处理组;市口径的试验区按城市匹配;据此生成 Treat(是否属于国家大数据综合试验区,是=1、否=0)、试验区名称与批复年月;
④ 政策年份取批复当年,即批复当年即进入政策实施期,各试验区的政策年份按批复文件确定(2015 年、2016 年两种);
⑤ 生成相对时间 = 年份 − 政策年份,即事件时间(event time),用于事件研究法刻画政策前后的动态效应,非试验区城市该列为空;
⑥ 以「该城市属于试验区、且当年已进入政策实施期」生成 DID,即DID = 1 当且仅当 Treat = 1 且 年份 >= 政策年份。
本资料为交错DID(staggered DID):各试验区政策年份为 2015 年与 2016 年两种,处理时点不一致,故按交错DID要求保留「相对时间」列,可直接用于事件研究、Goodman-Bacon 分解与 CSDID 估计。
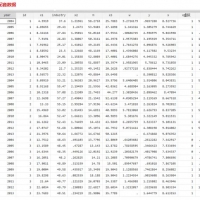
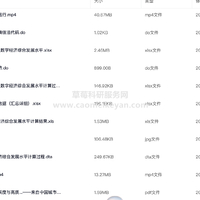
我们多做了几个变量,如下图所示,包括核心变量或者稳健性检验及过程变量,数据全流程公开,每个原始数据及过程都清晰可查(非主观编造),大家可以做核心变量或者稳健性检验,多个数据更加容易显著!
3、资料范围:
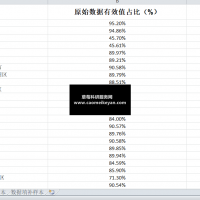
297 个地级市,7,722 个城市—年份观测值(297 × 26),年份跨度 2000-2025 年,其中处理组城市 57 个、处理组观测 1,482 个、DID=1 的城市—年份观测 576 个。具体数据分布情况如下方描述性统计。包括原始数据、计算代码(真实代码,可以向期刊公布,每一步都可以复现和做重复实验)、完整的复现说明(教大家一步步复现,做法过程全部公开,无数据黑箱,并且对复现过程常见问题做了解答)及最终结果(最终结果格式是excel电子表格格式,非常方便大家导入到自己数据里面),大家可以验证一下确保准确性!
需要说明的是我们did的每个地区的设立都是有政府官方文件对应的,非用人工智能ai直接生成,现在互联网的噪音比较多,人工智能ai会将其他不相关的内容都放入进去使其不准确!
4、参考文献:
[1]林伯强等. 大数据政策的绿色效应:碳回弹风险及其缓释机制[J]. 经济研究, 2026(8).
此数据为科研课题组自用数据,根据真实原始数据一步步做出来的,每一步都可以复现和做重复实验,非仅仅只有一堆文件胡编乱造(根据参考文献编造代码和结果根本就没有研究价值,不能反映真正的国家级大数据综合试验区布局水平,实证围绕着错的结果根本就毫无意义浪费大家时间),原始数据保证真实,就算数据源获取成本很高,也不删减简化;数据加工的每一步质控,绝不图省事偷减工序。修合无人见,存心有天知!
|
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有帐号? 建议用  立即注册
x

|
 [复制链接]


 窥视卡
 雷达卡
 发表于 2023-6-10 10:23:24
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜
 楼主