|
|
1、资料名称:2025-2000年上市公司创新知识溢出数据、知识溢出、知识溢出_同行业、知识溢出_异行业、知识溢出_同城市、知识溢出_含本企业、外部知识池规模
2、测算方式:
参考顶刊龙小宁等(2026)发表于《数量经济技术经济研究》的研究做法,利用上市公司发明专利摘要文本测算企业创新知识溢出指标。核心逻辑:若新申请专利与先期公开专利在文本内容上高度相似,则可推断发生了知识溢出。文献在城市对层面构造知识溢出指标,本文将其推广至上市公司层面,利用机器学习方法将专利摘要文本转换为TF-IDF向量,测算企业当年申请专利与其他企业近三年申请专利的文本相似度均值,作为企业接收的外部知识溢出。
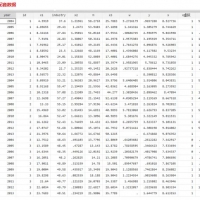
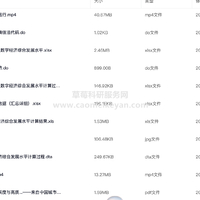
我们多做了几个变量,如下图所示,包括核心变量戗者稳健性检验及过程变量,数据全流程公开,每个原始数据及过程都清晰可查(非主观编造),大家鏯以做核心变量或者稳健性检验,多个数据更加容易显著!
3、资料范围:
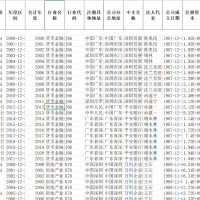
5663家上市公司,78514个观测值,年份跨度2000-2025年。
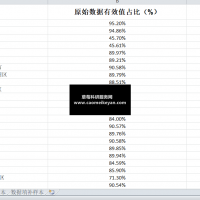
具体数据分布情况如下方描述性统计。
包括原始数据、计算代码(stata和python代码都有,真实代码,可以向期刊公布,每一步都可以复现和做重复实验)、完整的复现说明(教大家一步步复现,做法过程全部公开,无数据黑箱,并且对复现过程常见问题做了解答)及最终结果(最终结果格式是excel电子表格格式,非常方便大家导入到自己数据里面),大家可以验证一下确保准确性!
4、参考文献:
[1]龙小宁, 张帆, 易巍. 创新知识溢出的测度与检验——基于机器学习生成专利文本相似度的证据[J]. 数量经济技术经济研究, 2026(2): 54-79.
此数据为科研课题组自用数据,根据真实的上市公司专利数据一步步做出来的,每一步都可以复现和做重复实验,非仅仅只有一堆文件胡编乱造(根据参考文献瞎编结果根本就没有研究价值,不能反映真正的创新知识溢出水平,实证围绕着错的结果根本就毫无意义浪费大家时间),真正的原创一手认真整理数据,数据处理较为复杂大家可以自行试试。
|
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有帐号? 建议用  立即注册
x

|


 窥视卡
 雷达卡
 发表于 2022-8-20 14:02:55
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜