|
|
1、资料名称:2025-2000年上市公司年报文本信息语气数据、年报文本信息语气、积极词数量、消极词数量、积极词占比、消极词占比、年报总字数
2、测算方式:
参考顶刊王华杰、王克敏(2018)《会计研究》的研究做法,基于2000-2025年沪深A股上市公司年度报告全文文本,利用文本分析法构造年报文本信息语气指标。具体做法为:语气词库采用台湾大学制作的中文情感极性词典(NTUSD),将积极属性词语集(积极、进步等)与消极属性词语集(低迷、黯淡、不利等)分别作为积极、消极情绪词语列表,利用Aho-Corasick多模式匹配算法按最长匹配优先规则统计年报中积极词与消极词的出现数量(同一位置只计最长的词,避免子词重复计数),计算年报文本信息语气 WVS = (积极词数量 - 消极词数量) / (积极词数量 + 消极词数量),并输出积极词数量、消极词数量、积极词占比、消极词占比等过程变量。
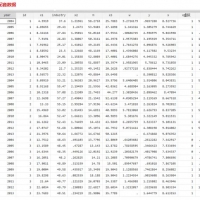
我们多做了几个变量,如下图所示,包括核心变量或者稳健性检验及过程变量,数据全流程公开,每个原始数据及过程都清晰可查(非主观编造),大家可以做核心变量或者稳健性检验,多个数据更加容易显著!
3、资料范围:
5803多家企业,73412多个观测值,年份跨度2000-2025年。
具体数据分布情况如下方描述性统计。
包括原始数据、计算代码(stata和python代码都有,真实代码,可以向期刊公布,每一步都可以复现和做重复实验)、完整的复现说明(教大家一步步复现,做法过程全部公开,无数据黑箱,并且对复现过程常见问题做了解答)及最终结果(最终结果格式是excel电子表格格式,非常方便大家导入到自己数据里面),大家可以验证一下确保准确性!
4、参考文献:
[1]王华杰,王克敏.应计操纵与年报文本信息语气操纵研究[J].会计研究,2018(4):45-51.
此数据为科研课题组自用数据,根据真实的A股上市公司年报全文一步步做出来的,每一步都可以复现和做重复实验,非仅仅只有一堆文件胡编乱造(根据参考文献瞎编结果根本就没有研究价值,不能反映真正的年报文本信息语气水平,实证围绕着错的结果根本就毫无意义浪费大家时间),真正的原创一手认真整理数据,数据处理较为复杂大家可以自行试试。
|
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有帐号? 建议用  立即注册
x

|


 窥视卡
 雷达卡
 发表于 2023-2-20 13:54:26
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜
 楼主