1、资料名称: 2025-2000年上市公司国家人工智能创新应用先导区DID数据、 、上市公司企业人工智能创新实验区数据
2、测算方式:
参考 一区ssci《Energy Economics》Wang S(2026) 对国家人工智能创新应用先导区(AI-IPZ)政策虚拟变量的构建方法,把工业和信息化部分三批批复先导区这一政策冲击构造为准自然实验,生成双重差分(DID)变量。核心操作步骤:
① 依据工业和信息化部批复复函及中国政府网、新华网等官方公开信息,逐条整理出国家人工智能创新应用先导区所覆盖的 1城市、批复年月与政策年份:
② 从上市公司基本信息中提取企业逐年注册地址所属省份、城市、区县,并把行政区划代码统一为 6 位文本代码(缺失值与 0 值保留为空);
③ 把企业当年注册地城市与先导区名单逐年匹配,生成 Treat(企业当年注册地城市在 样本期内是否被批复为先导区城市,是=1、否=0)、批复年月与政策年份(该城市被批复为先导区的年月与自然年份);
④ 政策年份取批复年份,即批复当年即进入政策实施期,与文献 Table 1 所列各批次 年份一致;
⑤ 生成相对时间 = 年份 − 政策年份,即事件时间(event time),用于事件研究法刻画政策前后的动态效应,非先导区城市该列为空;
⑥ 以「所在城市已被批复为先导区、且当年已进入政策实施期」生成 DID,即DID = 1 当且仅当 Treat = 1 且 年份 >= 政策年份,与政策时点严格对应;
⑦ 企业当年注册地跨城市变更时,Treat、政策年份、相对时间与 DID 随之逐年更新,与当年注册地城市口径严格一致,这也使政策批复之后新上市的企业能被准确纳入处理组。
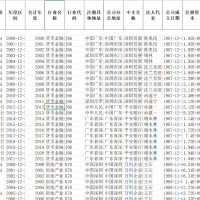
我们多做了几个变量,如下图所示,包括核心变量或者稳健性检验及过程变量,数据全流程公开,每个原始数据及过程都清晰可查(非主观编造) ,大家可以做核心变量或者稳健性检验,多个数据更加容易显著!
3、资料范围:
5,850 家企业,74,354 个年度观测值,年份跨度 2000-2025 年,其中处理组企业 2,536 家、
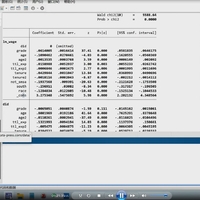
具体数据分布情况如下方描述性统计。
包括原始数据、计算代码(stata和python代码都有,真实代码,可以向期刊公布,每一步都可以复现和做重复实验 )、完整的复现说明(教大家一步步复现,做法过程全部公开,无数据黑箱,并且对复现过程常见问题做了解答)及最终结果(最终结果格式是excel电子表格格式,非常方便大家导入到自己数据里面),大家可以验证一下确保准确性!
相对时间 = 年份 − 政策年份,即事件时间(event time),用于事件研究法刻画政策前后的动态效应,大家做平行趋势检验和交错did时可以用到
4、参考文献:
[1]Wang S, Wan S, Chen S. Promoting urban green transformation: Evidence from China'snational artificial intelligence innovation application pilot zones on energy environmental performance[J]. Energy Economics, 2026, 158: 109309.
此数据为科研课题组自用数据,根据真实的国家人工智能创新应用先导区官方批复文件一步步做出来的,每一步都可以复现和做重复实验 ,非仅仅只有一堆文件胡编乱造(根据参考文献瞎编结果根本就没有研究价值,不能反映真正的人工智能政策试点布局水平,实证围绕着错的结果根本就毫无意义浪费大家时间),真正的原创一手认真整理数据,数据处理较为复杂。
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有帐号? 建议用 立即注册
x